
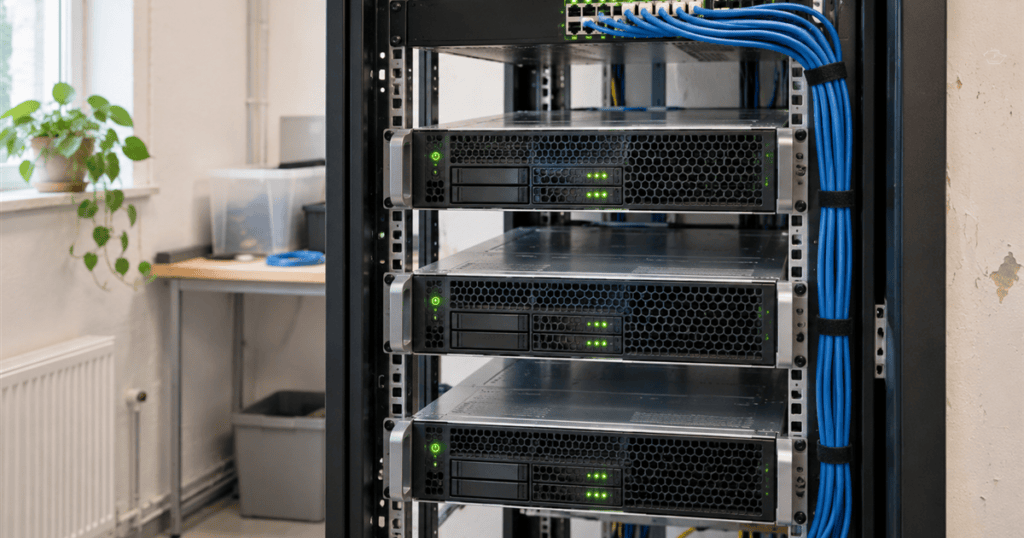
Flytter I Kubernetes fra en cloududbyder til egne servere, i eget rum eller i colocation, skal I selv levere alt det, udbyderen hidtil har stillet til rådighed under klyngen. Det gælder især fire ting: kontrolplanen, en load balancer, vedvarende lager og en fast rytme for opgraderinger.
Kubernetes er det samme system, uanset hvor det kører, og projektets licens er Apache 2.0. Forskellen ligger i, hvem der passer de lag, klyngen står på. Hos en cloududbyder bestiller klyngen selv en load balancer eller et volumen, og udbyderen leverer det. På egne servere er der ingen, der svarer, før I har sat noget op, der kan.
Det, I selv skal levere
Kontrolplanen. API-serveren, databasen etcd og de styrende komponenter skal køre på jeres egne maskiner. Skal klyngen tåle, at en maskine falder ud, skal kontrolplanen spredes over flere noder, og etcd skal have backup, der er prøvet. Projektets regler for versionsforskel sætter rammen: i klynger med høj tilgængelighed må API-serverne højst være én mindre udgave fra hinanden, og kubelet, agenten på hver node, må ikke være nyere end API-serveren og højst tre mindre udgaver ældre.
Load balancer. Hos en udbyder opretter klyngen selv en fordeler, når en tjeneste skal kunne nås udefra. På egne servere skal I vælge en løsning, der kan tildele adresser og fordele trafik, og den skal passe ind i jeres eget netværk og jeres firewall. Det er et af de punkter, der oftest tager længere end ventet.
Vedvarende lager. Containere med data skal have volumener, der overlever, at en container eller en node forsvinder. Løsningen kan være et eksisterende lagersystem med en driver til Kubernetes eller distribueret lager på noderne selv. Valget hænger sammen med det, I allerede har, se Lagring i eget miljø.
Opgraderinger. Kun de tre seneste mindre udgaver får rettelser fra projektet, og hver udgave er dækket i cirka et år, typisk med en ny rettelse hver måned. For en klynge på egne servere betyder det mindst én planlagt opgradering af kontrolplan og noder om året for at blive på en vedligeholdt udgave, og hyppige rettelser derimellem. Styresystemet på noderne kommer oveni.
Et eksempel på krav: Harvester
Harvester er en open source-platform til hyperkonvergeret infrastruktur, bygget på Kubernetes, med KubeVirt til virtuelle maskiner og Longhorn til distribueret bloklager, alle under Apache 2.0-licensen. Platformen er et eksempel på, hvad en samlet pakke kræver af hardwaren, pr. dokumentationen for version 1.6, læst 8. november 2026. Funktioner, der spænder over flere maskiner, forudsætter tre noder, og på én node mister I høj tilgængelighed, ekstra kopier og flytning af kørende maskiner. Hver node i produktion skal ifølge dokumentationen have 64 GB hukommelse eller mere, et netkort på 10 Gbit/s, mindst 500 GB disk og 16 kerner. Lageret skal være lokale diske eller hardware-RAID, og noderne skal have samme processorarkitektur.
Tallene er Harvesters egne og gælder ikke for andre platforme. De viser, at en produktionsklynge på egne servere hurtigt bliver tre maskiner af en vis størrelse, plus netværk, der kan følge med. Harvester og KubeVirt er beskrevet nærmere i Harvester og KubeVirt.
Eget rum eller colocation
Klyngen er ligeglad med, om racket står i jeres kælder eller hos et datacenter. Forskellen ligger i rummet: strøm, køling, adgang og forbindelser. I colocation lejer I plads, strøm og køling og beholder ansvaret for maskinerne, og det, I kan kræve af datacentret, står i kravene til et colocationdatacenter. To forbindelser ud af datacentret er et punkt for sig, når klyngen skal kunne nås udefra, se Forbindelser: to veje ud af datacentret.
Hvem driver det om natten
Hardwaren er den post, der er lettest at se. En klynge på egne servere kræver folk, der kan opgradere den, gendanne etcd, skifte en defekt disk og fejlsøge netværket, også uden for arbejdstid. Har I i dag én person, der kan det, er det en sårbarhed. Overvej, om en administreret platform, der kører på jeres eget udstyr, eller en leverandør med vagt kan dække en del af opgaven. Hvad platformen kræver i kompetencer, er belyst i Har I overhovedet brug for Kubernetes?.
Hvad det kræver, og hvad det koster at lade være
Opsætningen af en produktionsklynge med load balancer, lager, overvågning og backup tager for et lille team med erfaring fra en til tre måneder, før den første applikation kan flytte. Derefter kommer den løbende drift: opgraderinger, rettelser og vagt. I jeres eget regnestykke hører hardware med afskrivning, plads, strøm, køling, licenser til eventuel support og timerne til drift og vagt.
Undervurderer I driften, ender klyngen med at køre på en udgave, der ikke længere får rettelser, fordi opgraderingen hele tiden udskydes. Det er et sikkerhedsproblem, og det gør den næste opgradering større.
Det skal I lade være med
- At starte med én node i produktion · en enkelt node har ingen høj tilgængelighed.
- At vælge load balancer til sidst · den skal passe til jeres netværk og firewall fra dag ét.
- At planlægge uden opgraderingsrytme · skriv datoerne ind fra starten.
- At lade én person bære klyngen · drift og vagt skal kunne dækkes af flere.
Det skal valget kunne vise
- ☐ Antal noder til kontrolplan og arbejde, og hvordan etcd sikres.
- ☐ Valgt load balancer og lagerløsning, prøvet i jeres netværk.
- ☐ En plan for opgraderinger mindst én gang om året.
- ☐ Hvem der har vagten, og hvem der afløser.
Kilder
- Kubernetes, Releases og Version Skew Policy, læst 8. november 2026.
- Harvester docs v1.6 og Hardware and Network Requirements, læst 8. november 2026.
Senest gennemgået: november 2026.
Næste skridt
Skriv ned, hvem der i dag kan opgradere og gendanne en klynge, og hvem der kan tage over. Svaret afgør, om egne servere er realistisk.
Læs også: On premise, colocation eller cloud · Egen platform med egne IT-folk
→ Kontakt · Tlf. 70 13 63 23 · Jurisdiktions- og afhængighedsvurdering hos Nielco IT



